一、痛点:写代码很爽,写日志很苦
如果你问一个程序员:“你最讨厌的工作环节是什么?”
排在前面的答案里,一定有“写周报”“写更新日志”和“整理发版说明”。
日常开发中,我们的代码在不断提交,即时通讯软件里有无数的讨论,但到了月底或者发版时,面对空空如也的更新文档,大家往往只能靠“痛苦回忆”来拼凑:“我们这周到底干了啥?”“那个 Bug 是上周修的还是这周修的?”
如果要求大家每次提交代码后,都去后台管理系统手动录入一条“开发日志”,那大概率坚持不了一个星期。因为任何依赖人类自觉的额外操作,最终都会走向形式主义或消亡。
那么,有没有一种方法,能让我们在敲下 git commit 的那一刻,系统就自动帮我们把开发日志写好呢?
这就是我们在这个项目里玩的一个“偷懒”的高级操作:提交即文档。

简单命令,自行执行

Git提交自动生成的开发日志列表

Git提交自动生成的开发日志详情
二、核心意义:让用户听见产品的“心跳”
在讲技术实现之前,我们必须先聊聊:为什么我们要如此执着于把开发日志记录下来?
仅仅是为了方便技术团队内部对齐、方便领导看产出吗?
绝对不是。开发日志最大的价值,其实在用户端。
想象一下,当你使用一款软件时,如果它的更新日志永远停留在半年前,或者只有冷冰冰的“修复了一些已知问题”,你是不是会觉得这个产品已经“半死不活”了?
相反,如果一个产品有一个公开的“开发动态”时间线,你能看到:“昨天:优化了表格加载速度,现在丝滑了”“前天:新增了批量下载功能,满足了某某用户的呼声”“上周:重构了底层查询逻辑”
这种持续更新的动态,会给用户带来极大的安全感和信任感。 用户会真切地感知到:这个产品是“活”的,背后有一群人在不断打磨它、进化它。这种“养成系”的产品体验,是建立用户忠诚度的绝佳武器。
但是,问题来了:开发过程中的提交有成百上千次,里面甚至包含了很多试错过程、机密配置或者核心技术细节,可能并不适合展示公开。
当然不行!所以我们在底层数据库中设计了一张 admin.development_logs 表,并引入了一个极其关键的灵魂字段:is_public (是否可公开,Boolean 类型)。
🔹 对内(is_public = false):这是技术团队的“黑匣子”。比如“修复了由于某某配置配错导致的低级Bug”“重构了支付链路的核心加密算法(含机密)”。这些日志自动沉淀在管理端,方便团队内部复盘、追溯和审计。
🔹 对外(is_public = true):这是产品的“橱窗”。那些能带来业务价值的 feature(新功能)、能提升体验的 optimize(优化)、或者解决用户痛点的 fix(修复),会被标记为公开。后端 API 会根据这个字段进行过滤,将它们直接展示在租户端(用户端)的“开发动态”时间线里。
通过这个小小的布尔值开关,结合 occurred_at(发生时间)、log_type(日志类型)等结构化字段,我们完美地在“内部技术沉淀”和“外部产品营销”之间架起了一座桥梁。
三、揭秘魔法:什么是 Hook(钩子)技术?
既然要做到“无感记录”,我们就不能让程序员改变他们原有的工作习惯。他们还是像往常一样在终端里敲 git commit 和 git push。
那系统是怎么知道他们提交了代码,并偷偷把日志写进数据库的呢?
这里就用到了一个非常经典的编程概念:Hook(钩子)技术。
通俗点讲,你可以把 Hook 想象成智能家居里的“传感器”或者酒店门口的“门童”。假设你设定了一个场景:“当大门打开时,自动打开客厅的灯”。在这里,“大门打开”就是一个事件,而负责监听大门状态并触发开灯动作的机制,就是 Hook。
在我们的工程体系里:
🔹 事件:程序员在终端里敲下了带有 git commit 或 git push 的命令。
🔹 Hook(钩子):我们配置了一个进程级别的监听器。它就像一个尽职的门童,死死盯着终端的输入流。一旦正则匹配到了提交指令,它就会大喊一声:“有人提交代码啦!快去干活!”
🔹 触发动作:系统立刻在后台静默拉起一个 PowerShell 脚本(dev-log-db-ingest-hook.ps1),去 Git 仓库的 HEAD 指针处读取最新的 Commit SHA 和完整的 Commit Message,然后将其写入数据库。
通过 Hook,我们把原本毫不相干的“Git 提交”和“数据库写入”完美地缝合在了一起,实现了真正的“无感自动化”。
值得庆幸的是,对于Vs Code或Cursor这类现代化编程工具来说,实现Hook的定义极其简单。
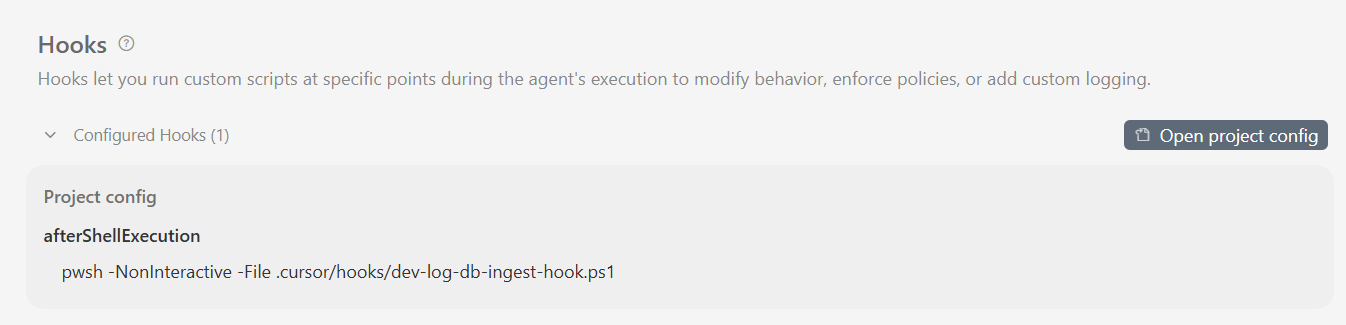

Cursor的Hook配置
四、AI 编程工具在这里扮演了什么角色?
在过去,要实现这样一个终端级别的 Hook,你可能需要去魔改 Git 的原生 hooks(比如 post-commit),这往往需要在每个开发者的电脑上单独配置,不仅繁琐,还容易因为操作系统环境不同而踩坑。
但现在,有了像 Cursor 这样的 AI 编程工具,事情变得优雅多了。
Cursor 不仅仅是一个帮你写代码的 AI,它还是一个高度可定制的开发环境。在 Cursor 中,我们直接利用了它原生的 afterShellExecution(终端命令执行后)Hook 能力。
我们在项目的 .cursor/hooks.json 里写了这样一段配置:
{
“hooks”: {
“afterShellExecution”: [
{
“command”: “pwsh -NonInteractive -File .cursor/hooks/dev-log-db-ingest-hook.ps1”,
“matcher”: “git (commit|push)”,
“timeout”: 20
}
]
}
}
这段配置的意思就是告诉 Cursor:“嘿,如果你看到我在终端里敲了匹配 git (commit|push) 正则表达式的命令,等命令执行完,你就帮我跑一下那个入库脚本,最多等它 20 秒。”
AI 工具在这里的作用,不是代替我们去思考,而是为我们提供了一个极其便利的自动化底座。 它把原本复杂的环境配置和进程监听,简化成了几行声明式的 JSON 代码。
五、结构化解析:把“程序员黑话”翻译成“人话”
抓到了提交事件只是第一步,更难的是:Git 提交信息往往很随意,怎么把它变成规整的数据库记录?
如果只是把 git log 原样塞进数据库的 Text 字段,那不叫开发日志,那叫“垃圾堆”。我们需要对它进行结构化解析。
我们的解析脚本(dev-log-from-git.ps1)会像一个聪明的语文老师一样,对提交信息进行“阅读理解”:
1. 自动分类(基于 Conventional Commits)
我们引入了业界通用的约定式提交规范。脚本会用正则表达式(如^(feat|fix|opt|refactor|docs|chore))去匹配提交信息的前缀:
🔹 匹配到 feat、add -> 自动映射为 feature(新功能)枚举值
🔹 匹配到 fix、bug -> 自动映射为 fix(修复)枚举值
🔹 匹配到 opt、perf -> 自动映射为 optimize(优化)枚举值
2. 自动拆分(一变多)
有时候,程序员攒了一大波修改,一次性提交了,提交信息里写了三个项目符号(- 优化了A、- 修复了B、- 新增了C)。如果直接存成一条日志,在用户端展示会显得很臃肿。
我们的脚本非常聪明,它会逐行扫描提交体,寻找以 - 或 * 开头的顶层子弹点(Bullet Points)。如果发现一次提交里包含了多个项目符号,它会在内存里构建一个 List,自动把这一次提交,拆分成多条独立的 INSERT 语句存入数据库!
这样一来,开发者依然可以按自己的习惯随性提交,而系统会自动把它们整理成条理清晰、适合展示的产品动态。
六、为什么不走高大上的 API,而是硬核地“直连”数据库?
懂点技术的同学可能会问:“既然要存数据库,为什么不调一个后端的 API 接口(比如 POST /api/development-logs)去存?为什么要用脚本在本地生成 SQL,然后直接塞给 Docker 里的数据库?”
这其实是一个非常务实且巧妙的工程考量。
如果依赖 API,那就意味着:每次你提交代码时,你的后端 Web 服务必须是启动状态的,网络必须是通的,JWT Token 必须是没有过期的。万一你只是在本地改个前端小脚本,后端服务根本没开,那日志就丢了。
为了让这个自动化流程足够皮实、足够抗造,我们选择了最硬核的路径:
- 脚本在本地解析好日志,在内存中拼接好 INSERT INTO admin.development_logs … 语句。
- 规避编码大坑:在 Windows 环境下,如果直接用 PowerShell 通过管道(Pipe)把包含中文的 SQL 传给 Docker 里的 psql,大概率会遇到诡异的字符截断或乱码。所以我们强制使用无 BOM 的 UTF-8 编码,将 SQL 写入操作系统的临时文件(.sql)。
- 执行 docker cp 将这个物理文件直接拷贝到 PostgreSQL 容器的 /tmp/ 目录下。
- 执行 docker exec … psql -f /tmp/xxx.sql 进行文件级导入,最后清理临时文件。
同时,我们还在 SQL 层面用 source_commit_sha(提交的唯一哈希值)做了防重处理:
IF EXISTS (SELECT 1 FROM admin.development_logs WHERE source_commit_sha = ‘$sha’) THEN
– 跳过,避免重复写入
哪怕你 commit 了一次,又 push 了一次,触发了两次 Hook,数据库也认得出来,从而实现了一个极度鲁棒的幂等写入链路。
这种设计,主打一个“悄无声息,使命必达”。
七、总结:自动化,是为了更好地专注
回过头来看,我们费这么大劲搞这套“提交即开发日志”的机制,到底是为了什么?
🔹 对开发者来说:消灭了写周报和整理更新文档的繁文缛节,让他们可以专注在写代码本身。
🔹 对团队来说:所有的研发过程被自动沉淀成了结构化的数据资产,随时可查、可统计。
🔹 对用户来说:他们能通过一个持续更新的“产品动态”窗口,看到这个产品的生命力,建立起对产品的信心。
在这个 AI 时代,我们不仅要用大模型帮我们写代码,更要学会利用 AI 工具提供的环境和自动化能力(比如 Cursor 的 Shell Hook),结合扎实的工程手段(正则解析、Docker 容器交互、幂等设计),去改造我们陈旧的工作流。
毕竟,把枯燥的重复劳动交给机器,把创造和思考留给人类,这才是技术的终极浪漫。
评论